
Intelligence Artificielle et Gestion des Données : 14 Cas d’Usage de l’IA
L’Intelligence Artificielle vaut ce que valent les données qu’on lui confie et le contexte qu’on lui donne. C’est l’enseignement le plus net des démonstrations de solutions que nous organisons avec les principaux éditeurs du marché, dans le cadre de notre Benchmark IA.
Normaliser une base, dédoublonner des fiches, prédire un comportement, construire un tableau de bord à partir d’une simple question : l’Intelligence Artificielle intervient désormais à chaque étape de la gestion des données, de leur préparation à leur analyse.
Nous avons répertorié 14 cas d’usage de l’IA dans la gestion des Données Clients, illustrés par des exemples d’outils du marché.
Cabinet de conseil en Données Clients et CRM, CustUp aide les entreprises à améliorer leur Performance Client par une meilleure gestion puis une meilleure exploitation de leurs données.
Page mise à jour le 02/11/2026.
Ce qu'il faut retenir
- L’IA intervient de la préparation des données jusqu’à leur analyse : normalisation, dédoublonnage, contrôle qualité, segmentation, prédiction, restitution. Les équipes métier prennent la main sur des opérations longtemps réservées aux équipes data.
- La valeur se joue dans la donnée et le contexte, pas dans le modèle : une IA qui ne comprend pas votre modèle de données produit des réponses plausibles mais fausses. Décrire ses tables, ses définitions et ses règles de calcul devient un chantier à part entière.
- L’IA utile tourne là où vivent les données : dans la CDP, l’entrepôt ou l’outil de BI, avec leurs règles d’accès. Exporter son fichier clients vers un assistant généraliste prive l’IA de contexte et pose un problème de conformité.
- Les données personnelles n’ont pas à atteindre le modèle de langage : les plateformes les plus sérieuses les masquent, les retirent des requêtes ou font passer l’agent par leurs propres outils. Posez la question avant de brancher un agent sur votre base.
- Normaliser les données clients avec l’IA
- Préparer ses données et créer des champs calculés en langage naturel grâce à l’IA
- Dédupliquer vos données et résoudre les identités clients avec l’Intelligence Artificielle
- Enrichir et fiabiliser les données produits avec l’Intelligence Artificielle
- Surveiller la qualité de ses Données Clients et détecter les anomalies grâce à l’IA
- Rendre ses Données Clients compréhensibles par l’IA : couche sémantique et contexte métier
- Créer des segments clients avec l’Intelligence Artificielle
- Prédire le comportement des clients grâce à l’Intelligence Artificielle
- Prédire les revenus futurs par segment client grâce à l’IA
- Analyser les verbatims et les données non structurées avec l’Intelligence Artificielle
- Analyser ses données grâce à l’Intelligence Artificielle
- Créer des comptes-rendus de tableaux de bord grâce à l’Intelligence Artificielle
- Générer des reportings et des tableaux de bord grâce à l’IA
- Protéger les Données Clients confiées à l’Intelligence Artificielle
- Ce que l’Intelligence Artificielle change dans la gestion des Données Clients
La normalisation homogénéise le format des données : adresses postales, numéros de téléphone, dates, civilités. C’est un préalable à toute exploitation de la base, y compris par l’IA elle-même.
Les plateformes de préparation des données savent désormais guider cette opération. Dataiku, par exemple, suggère les transformations pertinentes selon le type et les valeurs d’une colonne. Dans la capture ci-dessous, l’outil analyse les différents formats de dates présents dans la base, leur répartition, puis propose un format unique.

L’outil repère les formats de dates présents dans la base et propose un format unique (exemple : Dataiku).
L’intérêt tient moins à la suggestion qu’à ce qui l’accompagne. Chaque étape est documentée, rejouable, testée sur un échantillon avant d’être appliquée à toute la base. Une normalisation que l’on peut auditer est une normalisation que l’on peut industrialiser. À l’inverse, confier un export de fichier à un assistant généraliste pour « nettoyer les adresses » produit un résultat impossible à tracer, donc impossible à reproduire au prochain chargement.
La normalisation n’est qu’une des opérations de préparation que l’IA sait prendre en charge. L’évolution la plus marquante tient au mode de commande : l’utilisateur décrit en français la transformation souhaitée, l’outil la traduit en étape de préparation. Dataiku, par exemple, génère des étapes de préparation, des requêtes SQL et des enchaînements de traitements à partir du langage naturel.
Dans l’exemple ci-dessous, l’utilisateur demande de ne conserver que les cinq premiers chiffres d’un code postal américain. La plateforme crée l’étape correspondante, avec la même transparence que si elle avait été paramétrée à la main.

Une consigne en langage courant devient une étape de préparation (exemple : Dataiku).
Le même principe s’applique aux champs calculés, ces informations dérivées des données existantes : chiffre d’affaires cumulé, ancienneté, fréquence d’achat. Avec les attributs et les événements, ils forment les trois grandes catégories de données d’une base clients. Demander « calcule l’âge de chaque compte à partir de sa date de création » suffit désormais à créer le champ.

Le champ calculé est créé à partir d’une simple phrase (exemple : Dataiku).
Les Customer Data Platforms suivent le même chemin. Chez DinMo, l’agent Dan prépare un champ calculé à partir d’une demande, mais le livre en brouillon : rien n’est créé sans la validation de l’utilisateur. Et l’agent hérite de ses droits. Si vous n’avez pas le droit de créer un champ, Dan ne le pourra pas davantage.
Cette démocratisation a une contrepartie, à savoir qu’un champ calculé créé par un utilisateur métier devient vite une définition concurrente de celle de l’équipe data : deux « chiffres d’affaires cumulés » calculés différemment suffisent à faire diverger les tableaux de bord. La gouvernance des définitions devient d’autant plus nécessaire que l’IA rend la préparation accessible à tous. Les métriques qui engagent l’entreprise gagnent à rester définies une seule fois, en amont.
Dédoublonner une base clients, c’est reconnaître que « Anne Martin, 12 rue des Lilas » et « A. Martin, 12 r. des Lilas » désignent la même personne.
Deux approches coexistent :
- L’approche déterministe rapproche les fiches sur des règles explicites : même email, même numéro de téléphone, même identifiant client. Elle est simple, prévisible et auditable, mais laisse passer les doublons mal saisis.
- L’approche probabiliste, où intervient l’IA, calcule une probabilité de correspondance à partir de ressemblances partielles. Elle détecte ce que les règles manquent, au prix d’un seuil de confiance à régler et de faux positifs à surveiller.
AWS Entity Resolution illustre bien le choix à opérer : le service propose un rapprochement par règles, par machine learning ou via un fournisseur de données tiers. Il sait aussi ne traiter que les nouvelles fiches, plutôt que de recalculer toute la base à chaque chargement.

Règles, machine learning ou fournisseur tiers : trois façons de rapprocher les fiches (exemple : AWS Entity Resolution).
Dans plusieurs des Customer Data Platforms analysées dans notre Benchmark IA, la résolution d’identité fonctionne sans IA, par choix : règles déterministes, parfois complétées d’une option probabiliste paramétrable. C’est le cas de DinMo, dont le rapprochement des profils repose sur des règles configurables et auditables. Les éditeurs préfèrent un rapprochement qu’ils peuvent expliquer à un rapprochement plus complet mais plus opaque. L’Intelligence Artificielle devient pertinente quand les sources se multiplient, que les saisies sont hétérogènes et que les identifiants communs manquent.

Source : DinMo.
Toute entreprise qui s’intéresse à ses Données Clients s’intéresse aussi à ses données produits. Une recommandation ou un score d’appétence ne vaut que ce que vaut le catalogue qui les nourrit. L’IA sait catégoriser les produits selon l’arborescence de la marque, compléter les attributs manquants, rapprocher des catalogues issus de sources différentes, normaliser les fiches.
Ce cas d’usage a suivi le mouvement général : l’IA a rejoint l’outil où vivent les données.
Unifai, spécialiste français de la fiabilisation des données produits, a été racheté en 2023 par Akeneo, éditeur de PIM. La plateforme Akeneo recherche désormais sur le web les informations produits manquantes et suggère les valeurs directement dans le PIM. Elle propose aussi des structures d’attributs complètes, que les administrateurs valident, commentent ou rejettent dans un circuit de revue dédié.
Ce circuit de validation est le point à retenir. Sur un catalogue de dizaines de milliers de références, l’IA produit des suggestions à une cadence qu’aucune équipe ne saurait relire ligne à ligne : la gouvernance se joue dans les règles d’approbation. Ces données alimentent ensuite la recommandation de produits personnalisée et les modèles d’appétence.
Une base clients se dégrade avec le temps : un flux qui cesse d’alimenter une table, une source qui change de format, un magasin qui ferme et fait chuter les ventes de toute une zone. Les contrôles classiques reposent sur des règles écrites à l’avance. Ils ne repèrent que les problèmes que l’on a su anticiper.
L’Intelligence Artificielle change la donne de deux façons :
- Des agents de surveillance scrutent en continu les données et les indicateurs, puis signalent d’eux-mêmes les ruptures et les anomalies. Qlik a lancé début 2026 un agent de découverte dédié à ce travail. Là où un tableau de bord suppose qu’on aille le consulter, l’agent vient à vous.
- Les agents d’analyse repèrent les incohérences au fil de leur travail. Lors de notre évaluation de Splio, l’agent a relevé seul des taux de remise négatifs, qu’il a attribués à des retours avant de proposer de les exclure. Il a aussi demandé si un magasin dont la performance décrochait avait fermé.
Certaines plateformes dédient un agent à cette surveillance. Chez Batch, le Profile Data Alerting signale les attributs et les événements qui posent problème : une donnée qui n’est plus alimentée, des doublons, un format incohérent… Les données mal alimentées dégradent tout ce qui suit, à commencer par les scores prédictifs :
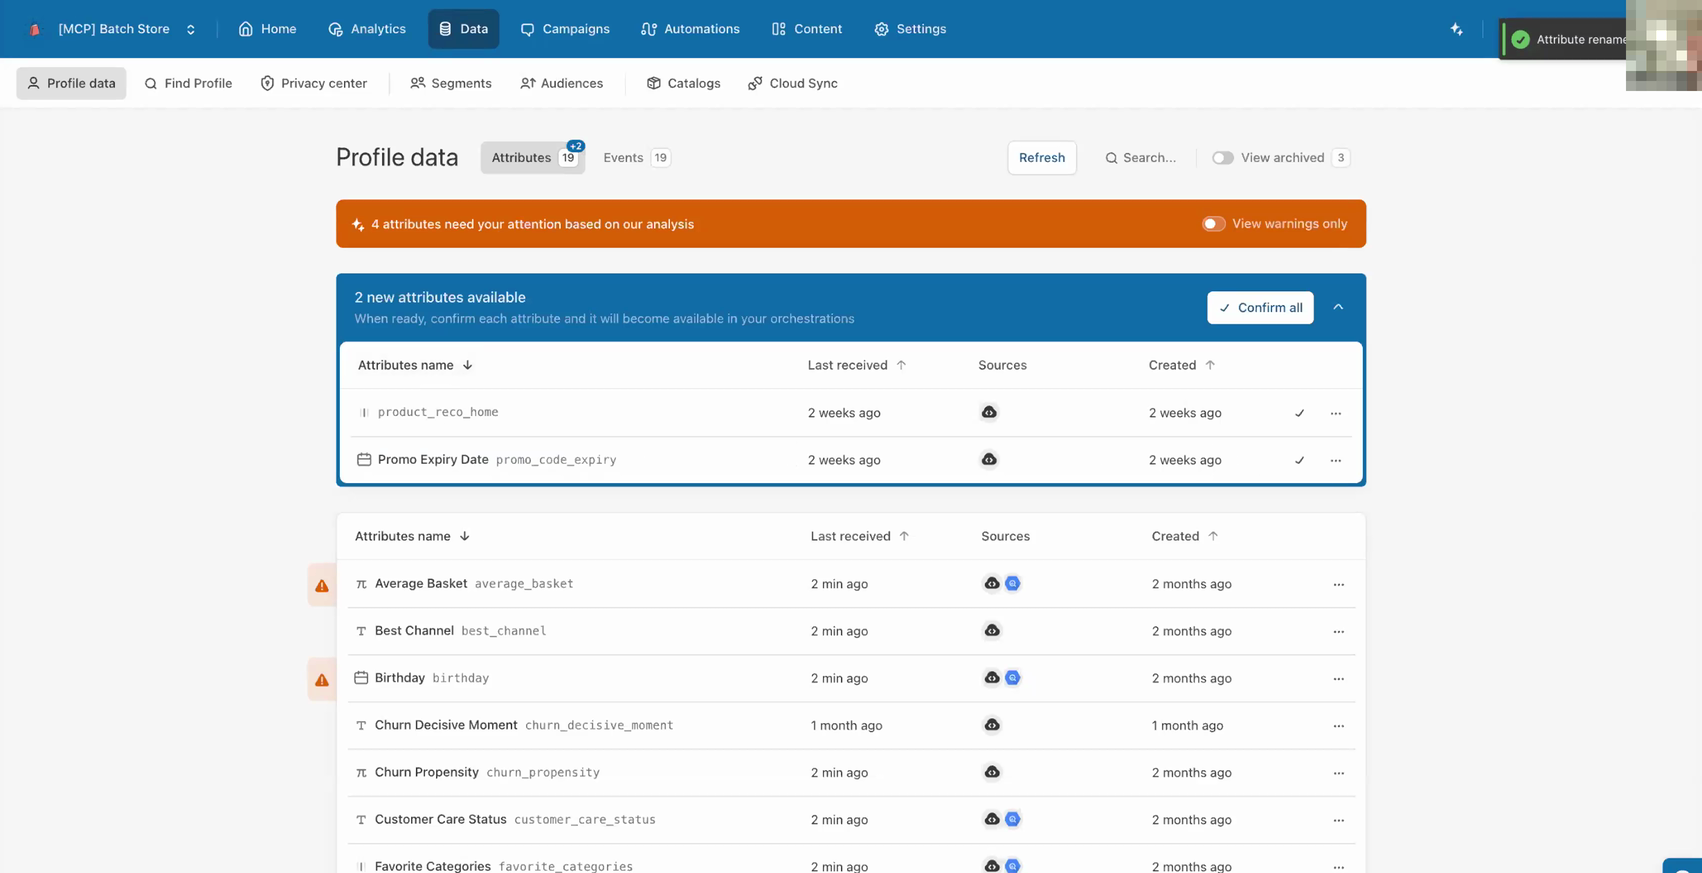
L’agent signale de lui-même les données qui ne sont plus alimentées ou mal formatées (exemple : Batch).
Le mécanisme le plus instructif reste celui de l’agent d’analyse : un agent qui questionne la donnée avant de conclure est un agent dont on peut suivre le raisonnement. Il suppose toutefois que quelqu’un réponde à ses questions. La détection d’anomalies déplace le travail : il ne s’agit plus de chercher les erreurs, mais de décider quoi faire de celles qu’on vous signale. D’où l’intérêt de désigner, dans l’organisation, un responsable de la qualité des Données Clients.
Une IA branchée sur une base qu’elle ne comprend pas produit des réponses plausibles et fausses. Elle ignore que la table « TRX » contient les ventes, que « statut 4 » désigne un client résilié, que le chiffre d’affaires se calcule hors taxes et hors retours.
Ce cas d’usage n’est pas une fonctionnalité parmi d’autres : c’est la condition de tous ceux qui suivent.
La réponse porte un nom, la couche sémantique. Il s’agit de décrire une fois pour toutes ce que signifient les tables, les champs, les relations entre eux, ainsi que les définitions métier et les règles de calcul.
Les éditeurs les plus avancés en font le socle de leurs agents :
- Splio traduit le modèle de données de chaque marque en ontologie, puis dote ses agents du vocabulaire du CRM : ce qu’est un churner, une segmentation RFM, une pression marketing. L’éditeur vise un socle commun à environ 80 %, complété par le contexte propre à chaque marque.
- Hightouch recommande de garder les métriques qui engagent l’entreprise, comme la LTV officielle ou le score de churn, définies en amont dans l’entrepôt de données, pour que tous les usages s’y réfèrent. Sa plateforme rassemble par ailleurs dans un espace dédié le contexte d’entreprise que ses agents consultent avant de produire.
- DinMo appelle cette couche le Context Layer. Elle réunit un glossaire de définitions métier (abonné email, client actif, client perdu…), validées par un administrateur avant de faire foi. S’y ajoutent des notes qui décrivent les règles de la maison. Certaines notes sont épinglées : l’agent les lit à chaque échange.
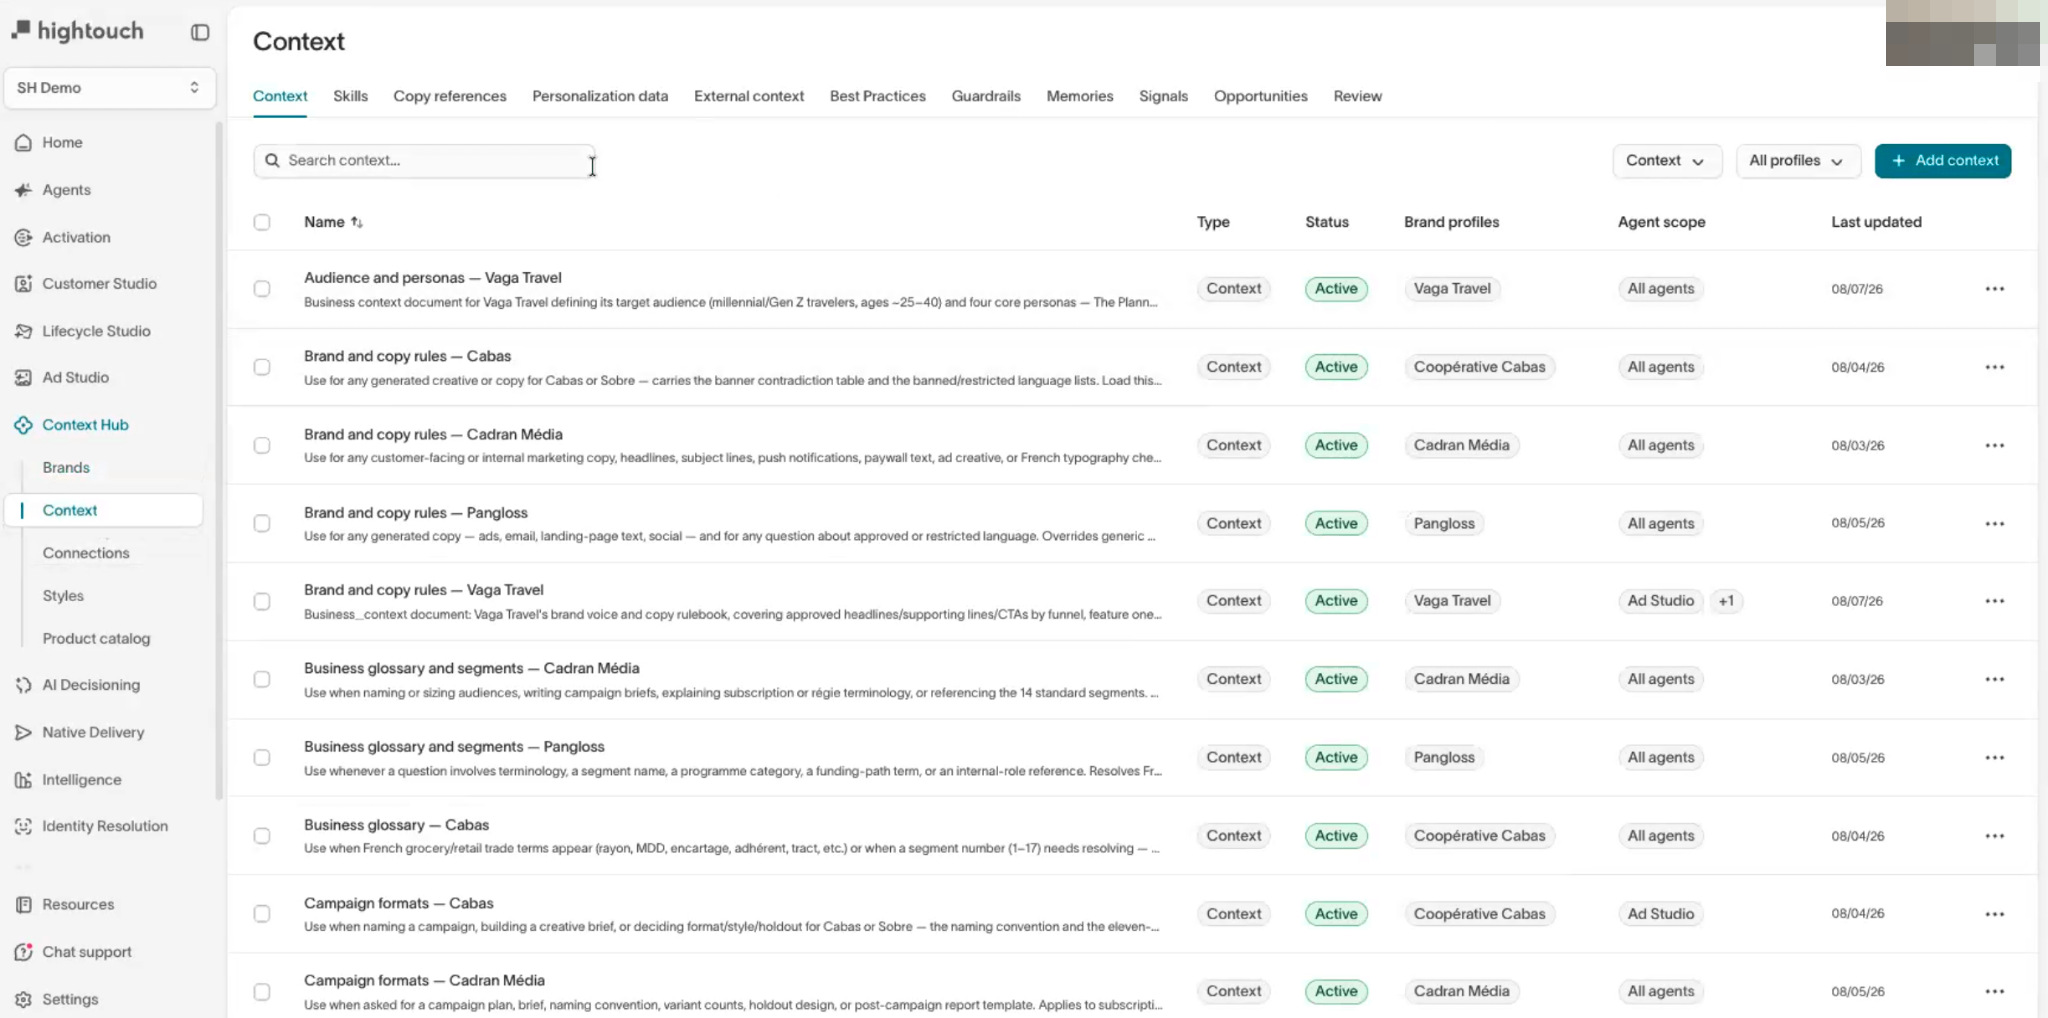
Le contexte de l’entreprise est décrit une fois, puis consulté par tous les agents (exemple : Hightouch).
Chez DinMo, le glossaire et les notes partagent le même écran :
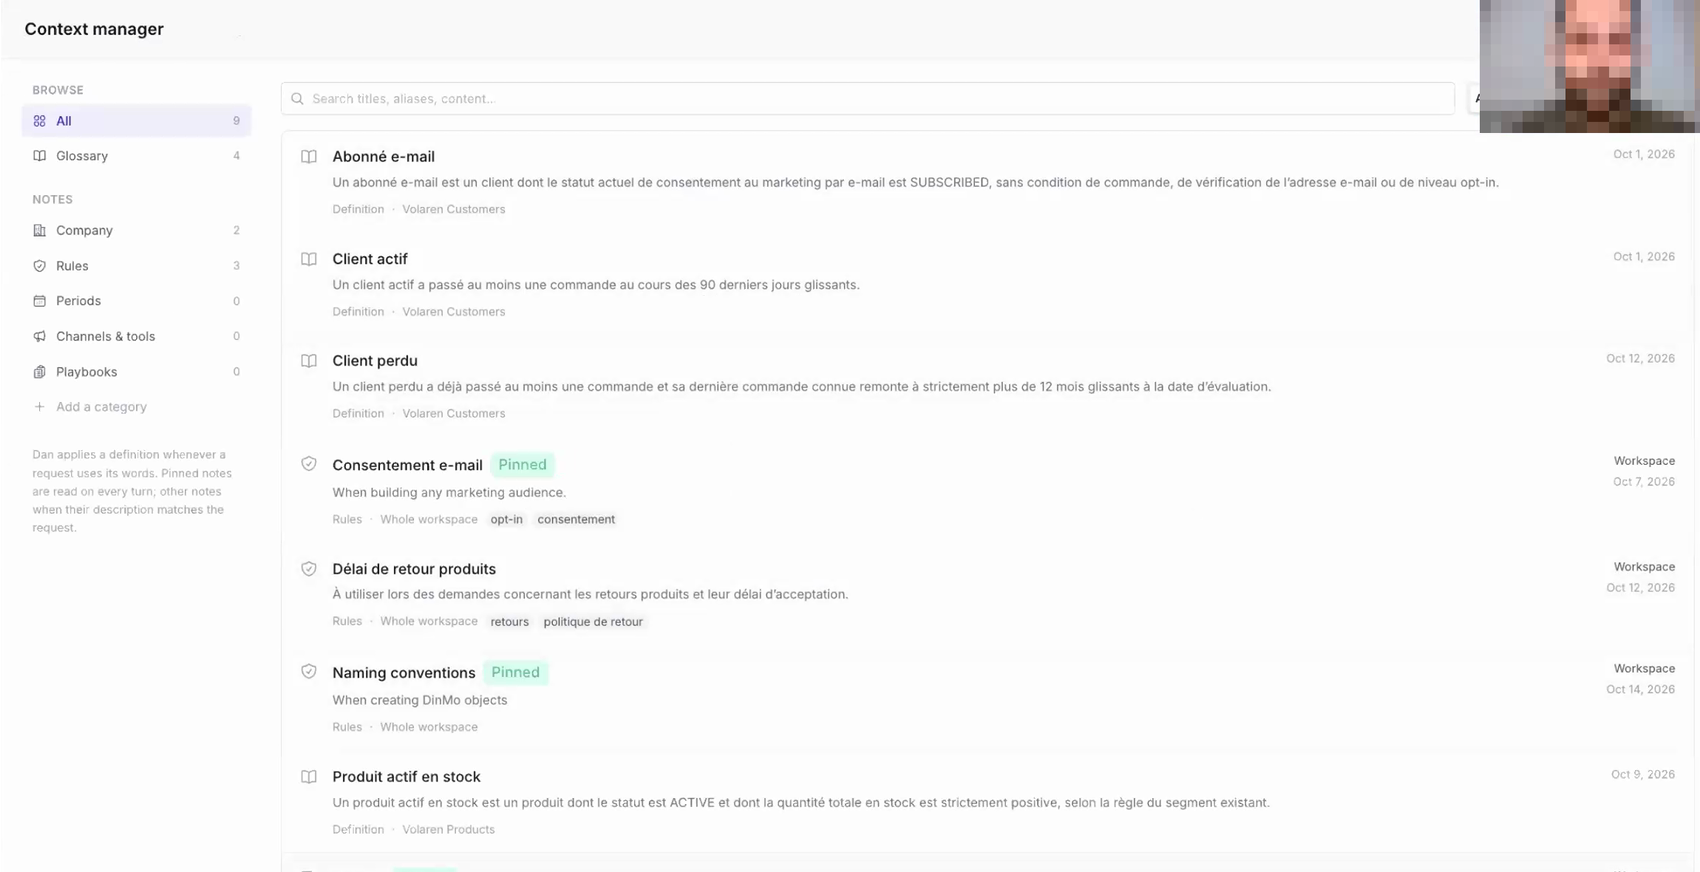
Des définitions validées et des notes que l’agent consulte avant de répondre (exemple : DinMo).
Plus modeste mais très utile, le Profile Data Renaming de Batch propose un nom métier lisible pour chaque champ technique (« Average Basket » plutôt que average_basket). Un premier pas vers une base que le marketing (et l’IA) comprend.
Démonstration après démonstration, le constat est le même : la qualité d’une réponse ne vient pas du modèle de langage, elle vient de ce que la plateforme sait de vos données. Ce travail relève autant du métier que de la donnée. Il ne s’improvise pas au moment de brancher un agent. Le glossaire a d’ailleurs un mérite qui dépasse l’IA : il oblige le marketing à formaliser son vocabulaire, au bénéfice des humains autant que de l’agent.
Grâce au no code, les équipes métier construisent leurs segments sans SQL, en combinant attributs, événements et règles. La difficulté a changé de nature : elle ne tient plus à la technique, mais au choix de la bonne combinaison pour obtenir un segment qui a un sens marketing.
L’Intelligence Artificielle intervient ici à trois niveaux :
- Elle traduit une description en langage naturel en règles de segmentation. Chez Hightouch, par exemple, l’agent explique comment il traduit chaque critère métier en colonne de la base, ce qui permet de le contredire. Il applique aussi de lui-même les garde-fous attendus, comme l’exclusion des profils sans consentement. L’agent Dan de DinMo livre de son côté ses segments en brouillon, avec leur définition lisible et le contexte appliqué. Chez Creatio, un agent traduit une demande en filtre sur une liste du CRM.
- Elle relit un ciblage existant. L’agent d’analyse de ciblage de Batch traduit une segmentation en langage clair et signale ses incohérences, comme une audience qui serait vide.
- Elle construit l’ensemble du dispositif. Treasure AI (ex-Treasure Data) propose un espace conversationnel où l’on crée segments, parcours et campagnes en langage naturel, avec une relecture humaine avant activation.
Voici l’agent de Batch à l’œuvre sur un ciblage :
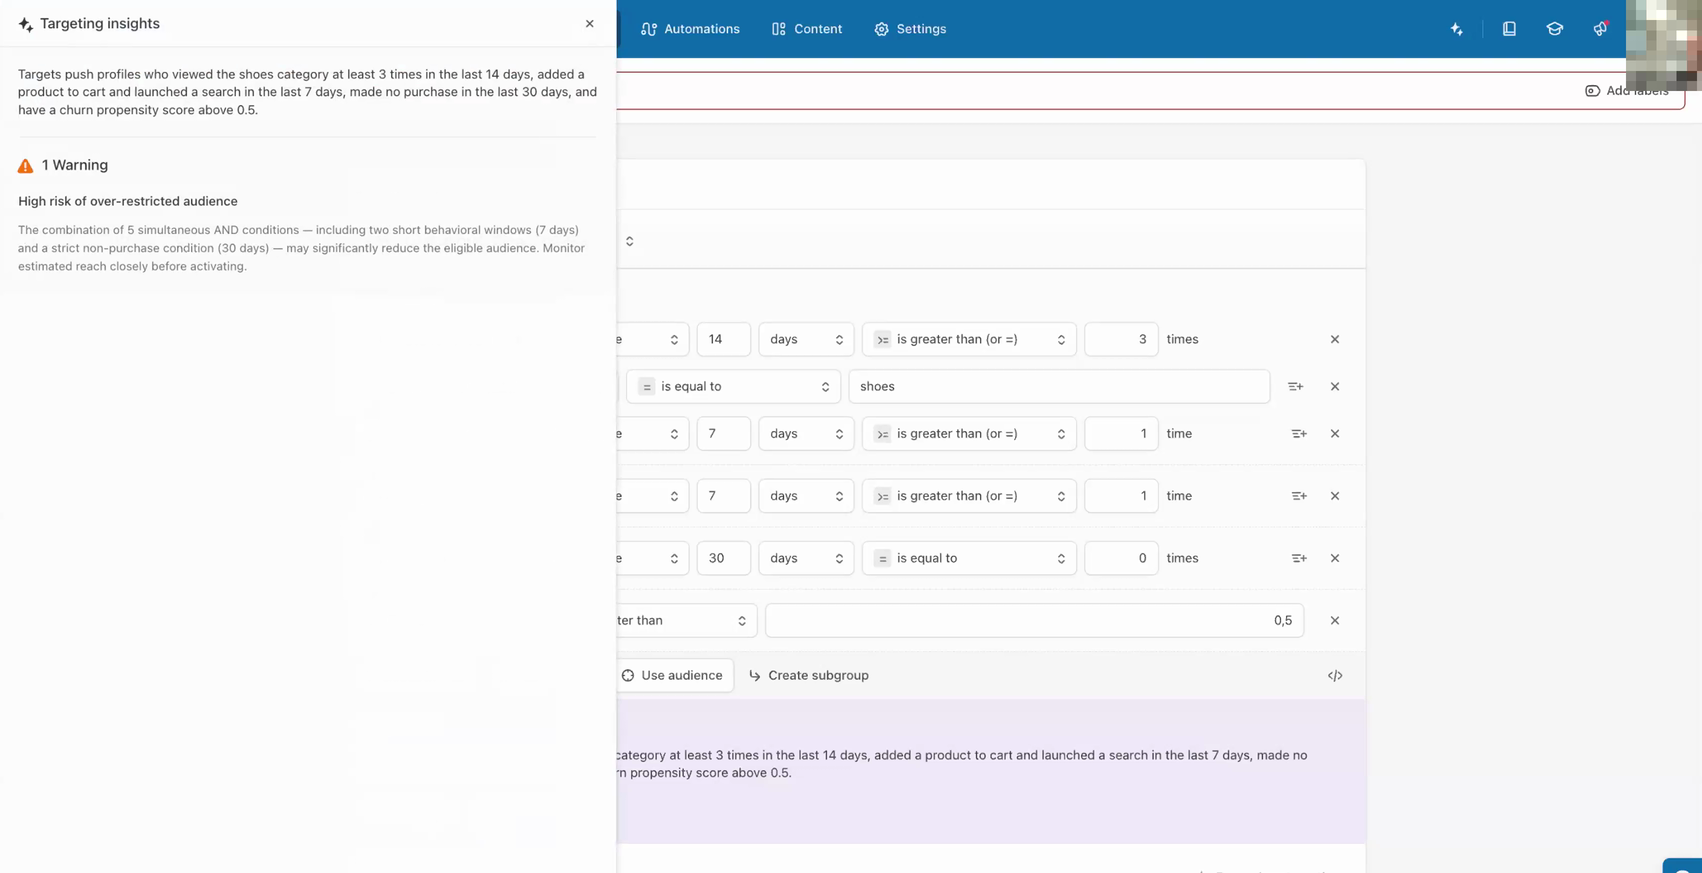
Le ciblage est traduit en langage clair et ses incohérences sont signalées (exemple : Batch).
Côté données, ce cas d’usage n’est fiable qu’à une condition : des champs aux noms et aux définitions compréhensibles par le marketing. Sans cela, l’agent traduit fidèlement la demande sur des colonnes qu’il comprend mal. Nous détaillons l’usage marketing de ces segments (et les limites que nos consultants lui trouvent au quotidien) dans la page consacrée aux cas d’usage de l’IA en CRM Marketing.
Prédire le comportement futur des clients à partir de leurs comportements passés reste l’une des grandes familles de cas d’usage de l’IA appliquée aux Données Clients. Probabilité d’achat, risque de départ, appétence pour une catégorie : ces scores reposent sur des algorithmes d’apprentissage automatique entraînés sur l’historique de la base.
La nouveauté tient à leur intégration. Les modèles prédictifs vivent désormais dans les plateformes de Données Clients, s’entraînent seuls puis se mettent à jour sans intervention :
- Hightouch ajoute à ses attributs clients des scores prédictifs, comme la propension d’achat à sept jours ou le risque de churn. Ils sont entraînés automatiquement sur l’historique des événements et rafraîchis selon un calendrier défini.
- SAS pousse l’explicabilité le plus loin avec SAS 360 Marketing AI. Le marketeur choisit un objectif plutôt qu’un algorithme, puis voit quelles données ont pesé dans chaque prédiction et avec quelle fiabilité.
- Batch AI Predict propose 15 scores rangés selon la question à laquelle ils répondent : qui cibler, quand déclencher, quelle offre proposer. Chaque client a ses propres modèles, entraînés sur ses seules données.
- Creatio propose cinq types de modèles configurables sans code (scoring de 1 à 100, prédiction numérique, recommandation…), entraînés sur les seules données du client.
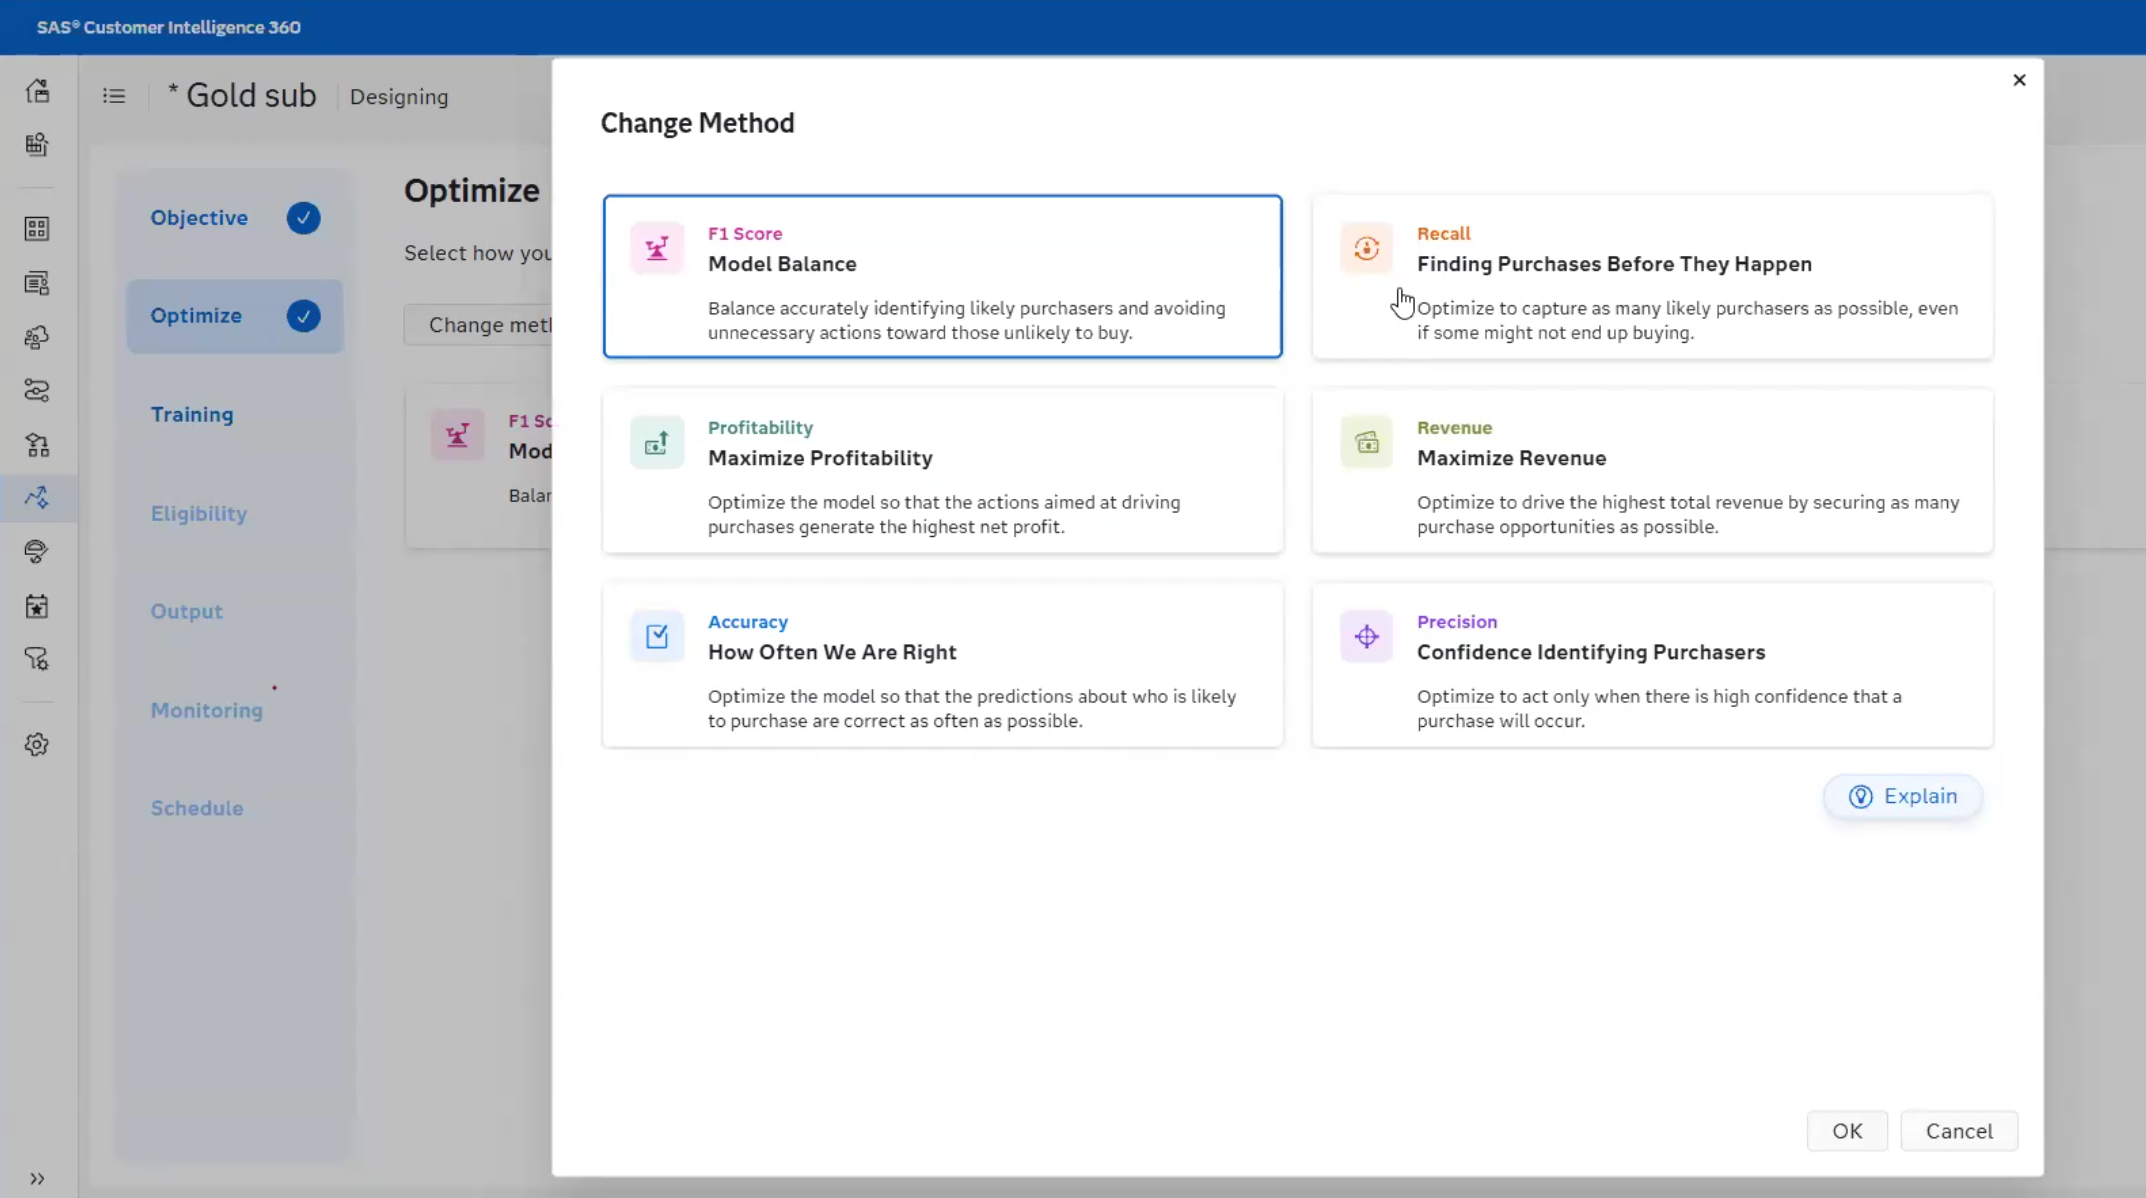
Le marketeur choisit un objectif métier, la solution sélectionne ensuite les méthodes statistiques (exemple : SAS).
Côté Batch, les scores s’organisent ainsi :
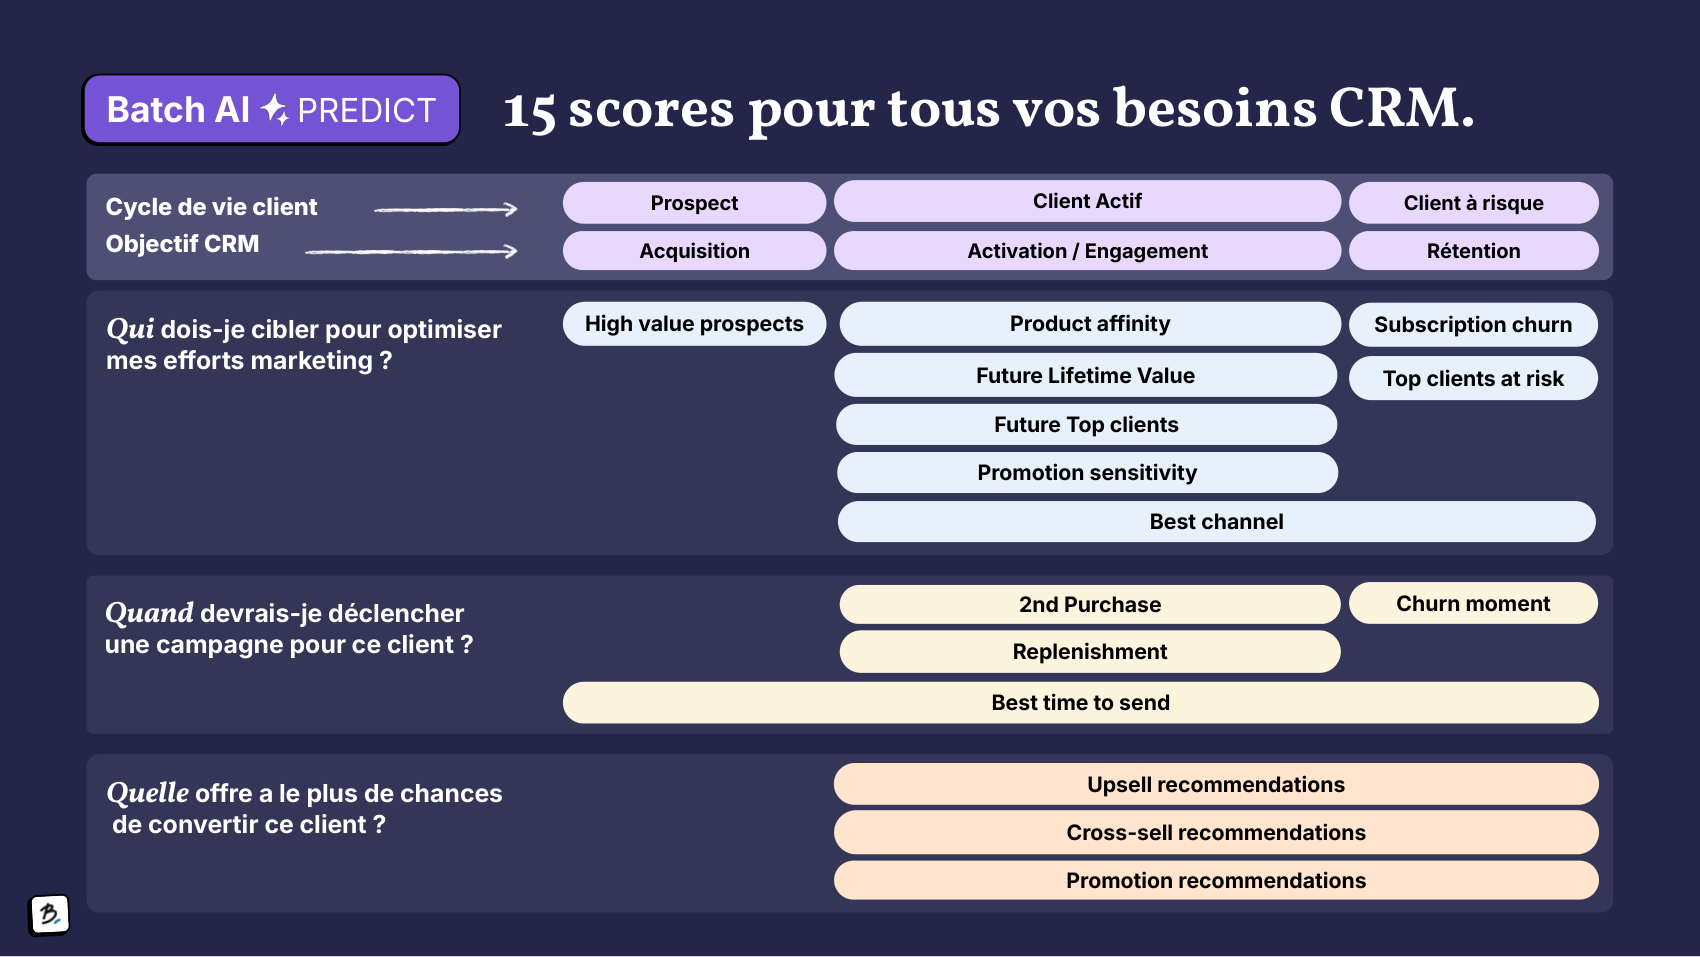
Quinze scores prédictifs rangés par question métier (exemple : Batch).
Splio, qui a absorbé la technologie prédictive de Tinyclues, en a fait de son côté le socle de toute sa plateforme. Et l’Event Propensity Scoring de DinMo calcule la probabilité de n’importe quel événement dans un horizon choisi. Plus intéressant, il historise ses prédictions et prévient quand les résultats observés s’éloignent de l’évaluation, signe qu’un réentraînement s’impose :
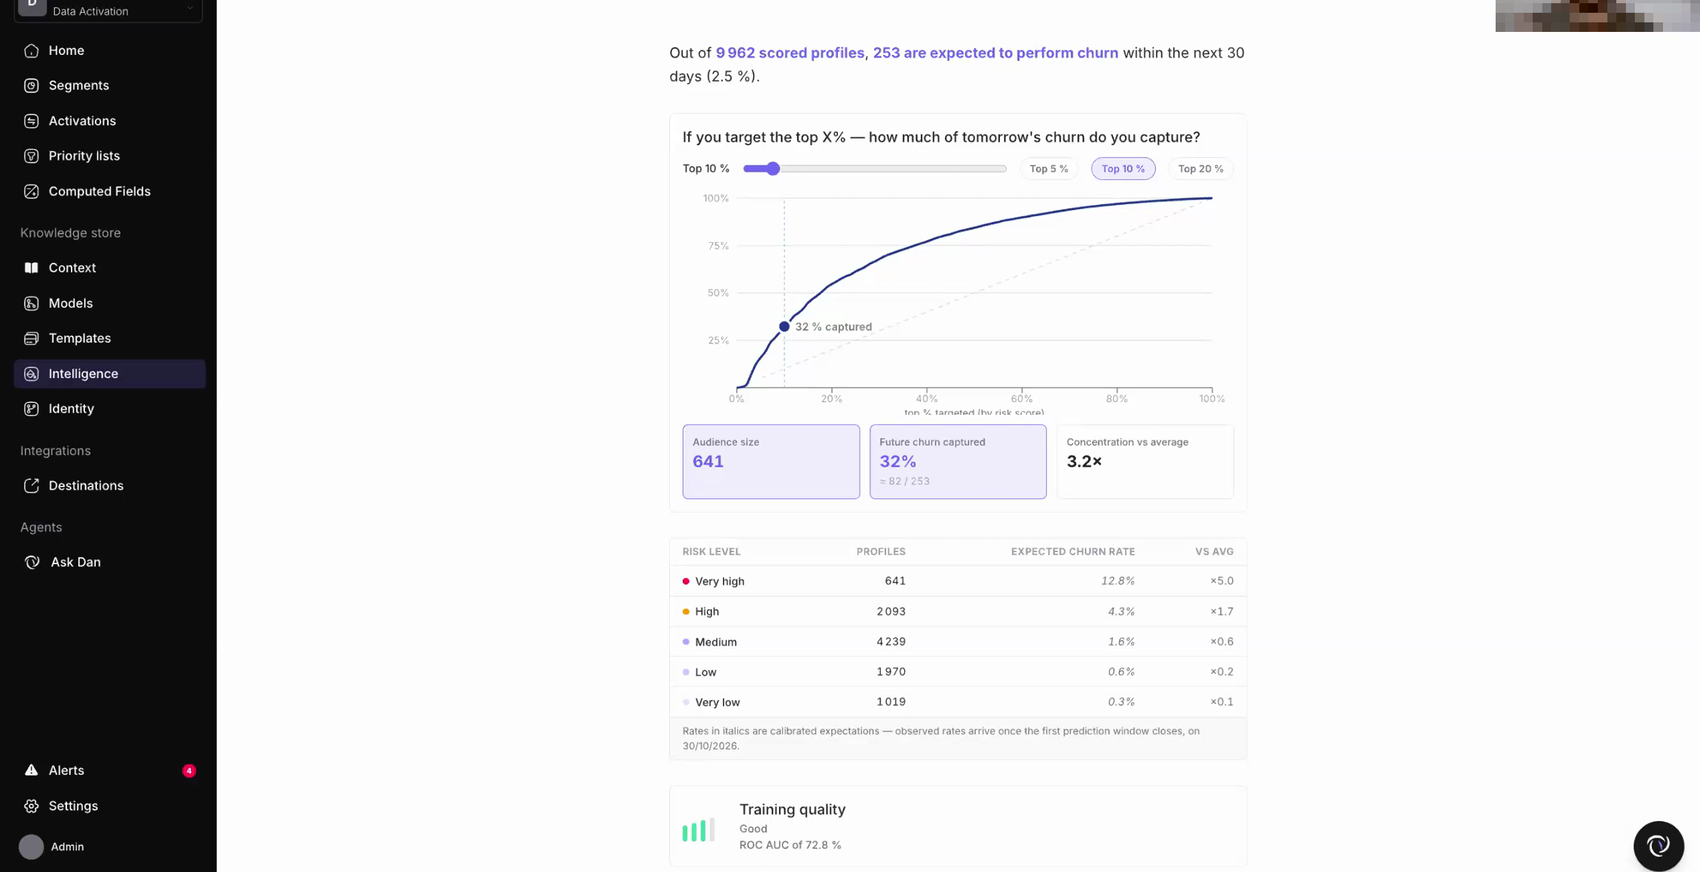
Un score de propension, avec l’aide au choix du seuil de ciblage (exemple : DinMo).
Cette détection de dérive est précieuse. Nous voyons trop souvent des scores mis en production puis oubliés, jusqu’au jour où plus personne ne leur fait confiance. Un conseil avant de déployer un modèle, quel que soit l’outil : demandez à voir ce qui le compose, comment il est surveillé dans le temps, ce qui déclenche son réentraînement. Un score que l’on peut expliquer est un score que l’on ose utiliser.
Cas d’usage plus étroit, mais d’un intérêt business direct : estimer ce que chaque segment de clients rapportera dans les mois à venir.
Deux notions sont souvent confondues :
- La valeur future correspond aux revenus attendus d’aujourd’hui jusqu’à un horizon donné.
- La LifeTime Value ajoute à cette prévision tout ce que le client a déjà rapporté.
Optimove calcule cette valeur future à partir des micro-segments de sa plateforme. L’outil observe comment les clients migrent d’un micro-segment à l’autre au fil du temps, puis ce que rapporte en moyenne chacune de ces migrations. La combinaison des deux donne la valeur attendue de chaque segment.
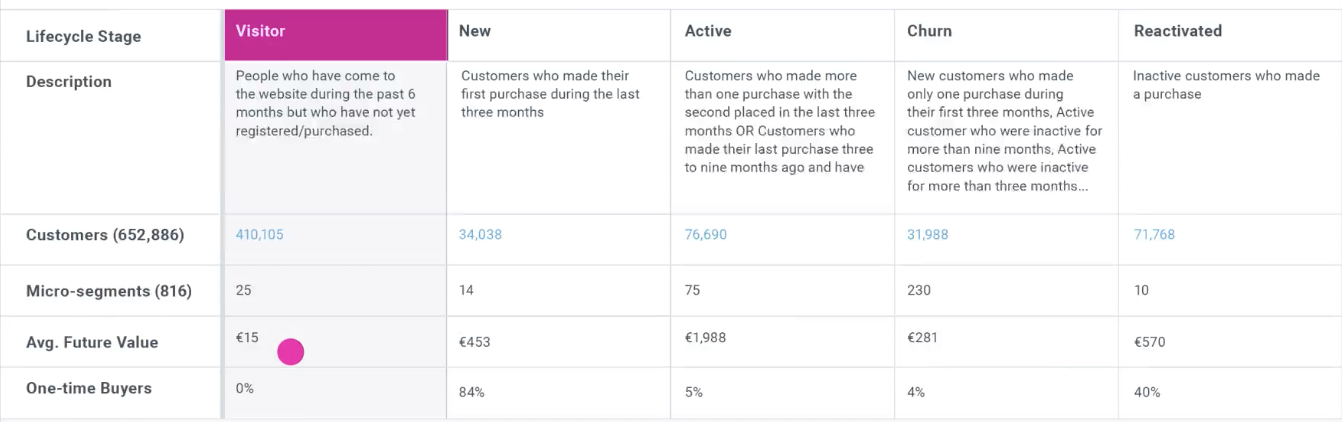
La valeur attendue de chaque micro-segment (exemple : Optimove).
Les CDP calculent aussi cette valeur client par client. DinMo produit des scores de LTV et de churn à partir d’environ douze mois d’historique, Batch une valeur future parmi ses 15 scores. Le score s’agrège ensuite par segment comme n’importe quel attribut.
La prévision devient aussi accessible aux équipes d’analyse. Pecan propose depuis 2026 un agent prédictif : on lui pose une question métier en langage courant, par exemple la valeur attendue des clients recrutés dans l’année. L’agent prépare les données, construit puis valide le modèle, enfin pousse les résultats dans les outils de l’équipe.
Ces prévisions changent la façon d’arbitrer les budgets : investir sur le segment qui rapportera le plus demain, pas sur celui qui a le plus rapporté hier.
Une grande partie de ce que disent les clients (avis clients, conversations avec le service client…) échappe aux tableaux de données. L’analyse sémantique des verbatims existe depuis longtemps, sous forme de détection de thèmes et de mots-clés. Les modèles de langage l’ont rendue beaucoup plus fine. Ils calculent un score de sentiment, repèrent une intention de départ, résument les motifs d’insatisfaction récurrents. Ce score de sentiment complète les indicateurs de satisfaction classiques : Net Promoter Score, CSAT, Customer Effort Score.
Mais le vrai progrès est ailleurs. Longtemps, ces analyses sont restées dans des outils d’écoute client, séparés du fichier clients. La tendance est désormais de rattacher ces signaux au profil de chaque client. Adobe Real-Time CDP intègre ainsi aux profils les journaux du centre d’appels, les conversations écrites et les interactions vidéo, pour donner aux agents d’IA un contexte plus riche.
Un score de sentiment isolé renseigne sur une moyenne. Rattaché au profil, il devient actionnable : on ne relance pas de la même façon un client dont la dernière conversation s’est mal passée. Encore faut-il que la plateforme sache stocker ces données. Toutes n’en sont pas capables : la question mérite d’être posée au moment du choix. Côté Service Client, nos cas d’usage de l’IA en Service Client détaillent l’analyse des conversations et des irritants.
Obtenir une réponse chiffrée à une question précise, sans passer par une demande à l’équipe data : c’est la promesse des assistants d’analyse en langage naturel. Une question en français devient une requête, la requête devient un chiffre, un graphique, une réponse argumentée.
Deux familles d’outils s’y attaquent. Leur fiabilité n’est pas la même :
- Les assistants qui génèrent directement une requête sur les tables brutes. Rapides à mettre en place, ils produisent des réponses plausibles mais fragiles dès que le modèle de données se complique.
- Les assistants adossés à un moteur analytique et à une couche sémantique. Qlik Answers, disponible depuis février 2026, confie les calculs au moteur de Qlik. Le modèle de langage n’intervient que pour interpréter puis restituer, en citant les jeux de données utilisés.
DinMo a fait un choix d’architecture voisin, que nous trouvons décisif. Son agent Dan Analyst n’écrit pas de SQL : il demande à un outil d’analyse de la CDP d’exécuter le calcul. Le modèle de langage n’accède donc jamais au data warehouse ni aux données personnelles. Et la méthode devient lisible, étape par étape, hypothèses comprises :
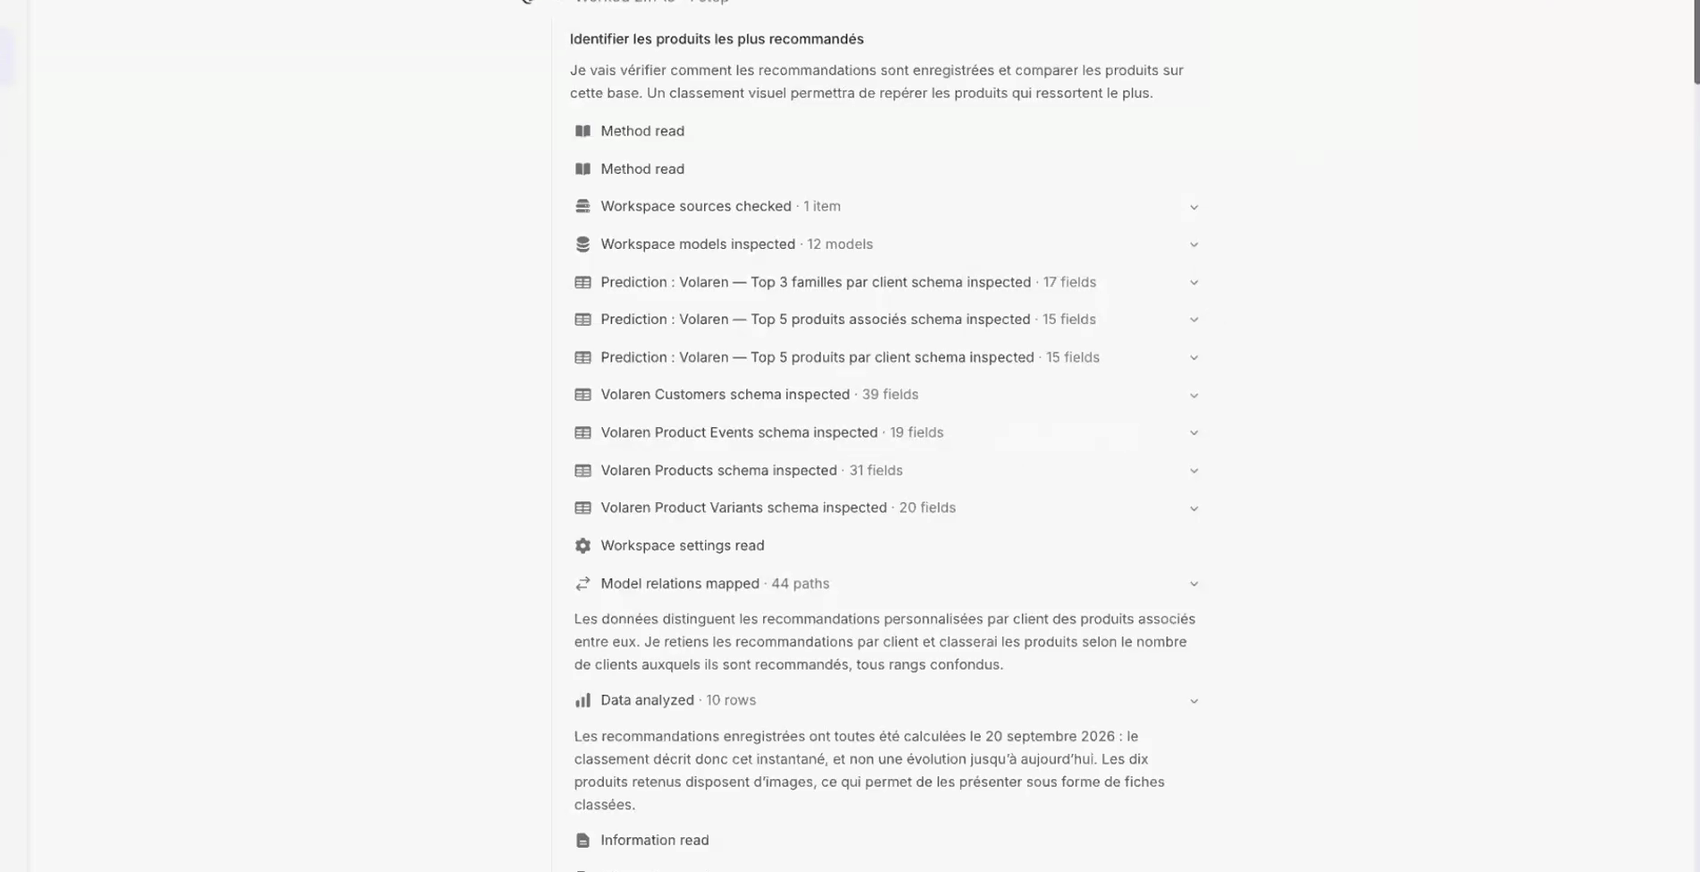
On sait ce que l’agent a regardé avant de répondre (exemple : DinMo).
Un marketeur qui ne lit pas le SQL peut ainsi repérer une erreur d’interprétation. La différence se voit sur les questions difficiles : un calcul de marge, une comparaison entre périodes, une définition métier ambiguë. Qlik permet par ailleurs d’interroger ses données gouvernées depuis un assistant comme Claude ou ChatGPT, via le protocole MCP. L’interface change, la gouvernance voyage avec la donnée.
Un tableau de bord montre des chiffres mais ne dit pas ce qu’il faut en retenir. Générer automatiquement un commentaire en langage courant, pour l’ensemble d’un rapport ou pour quelques graphiques sélectionnés, fait gagner un temps réel à ceux qui doivent présenter ces chiffres en comité de direction.
Cette fonction s’est généralisée dans les outils d’analyse. SAS en fait un argument à destination des directions, avec des synthèses de décision et une mise en récit des résultats produites par SAS Viya Copilot, l’assistant intégré à sa plateforme analytique.
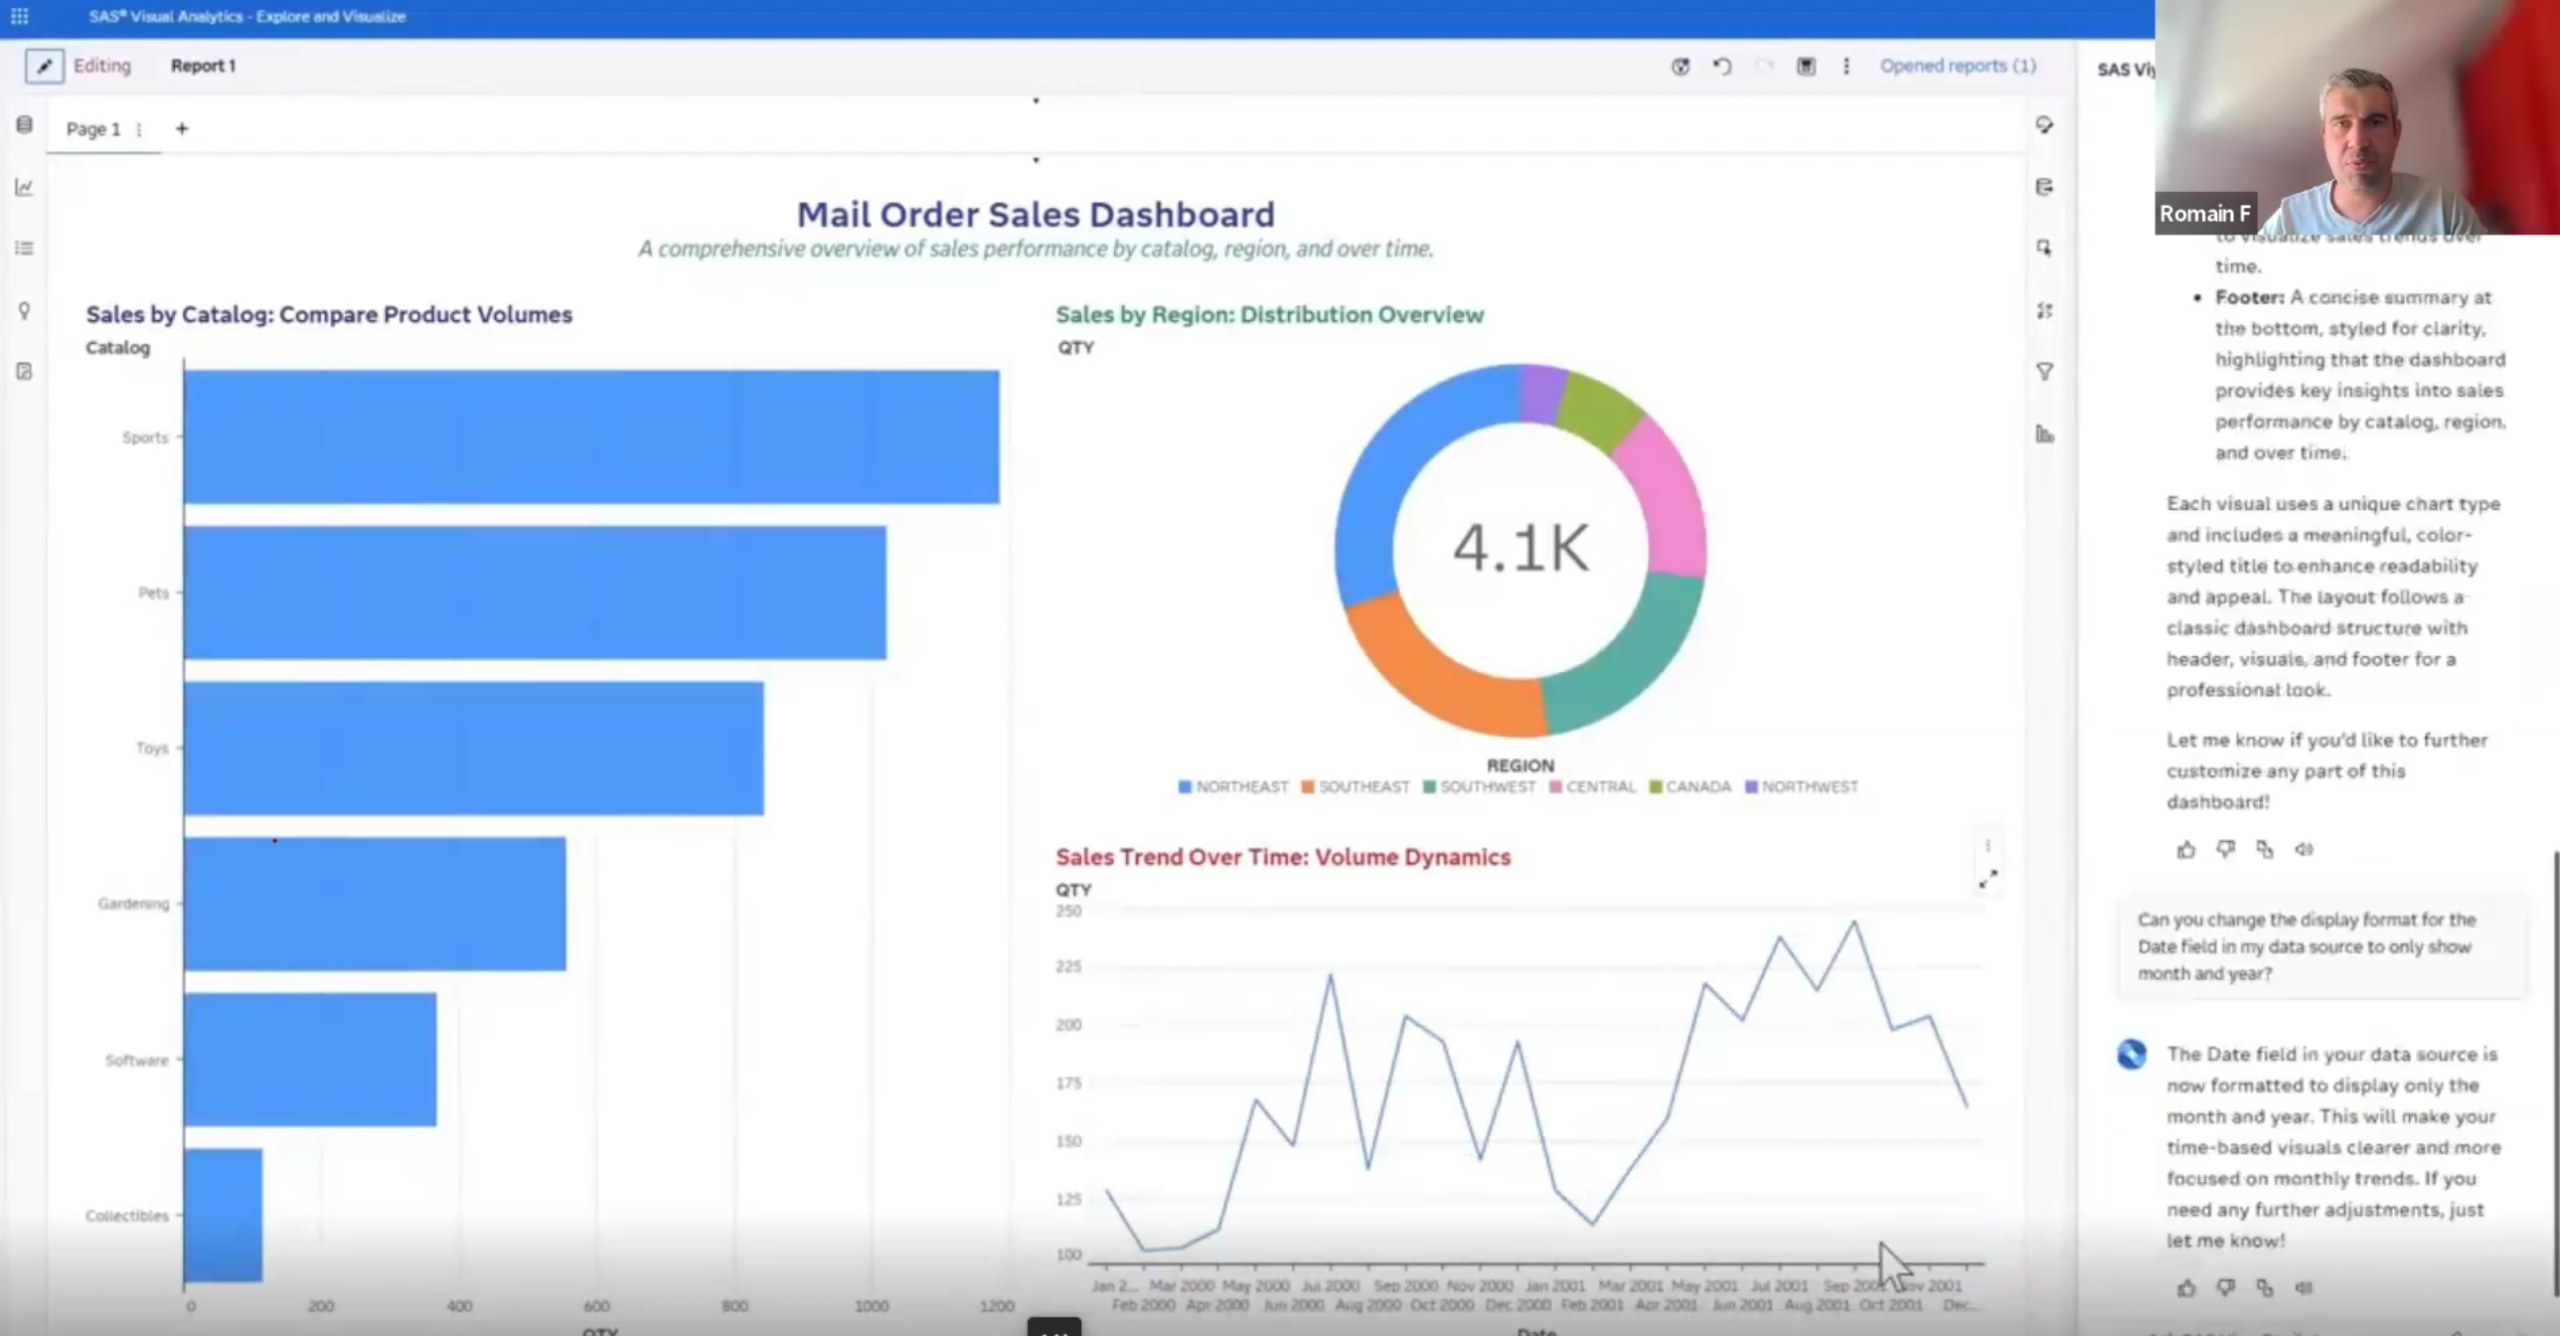
Le tableau de bord s’accompagne d’une lecture rédigée par l’IA (exemple : SAS Viya).
Le commentaire généré appelle la même vigilance que toute sortie d’IA : il décrit ce que montrent les chiffres, pas ce qui les explique. Un recul des ventes peut venir d’une rupture de stock, d’un changement de périmètre ou d’une erreur de chargement. C’est à l’analyste de faire la différence. Le commentaire automatique lui en laisse précisément le temps.
Dernière étape : ne plus seulement interroger ou commenter, mais construire. L’utilisateur formule une demande, l’outil génère un tableau de bord complet, avec des visualisations adaptées à la question.
C’est la séquence qui a le plus marqué l’équipe de consultants CustUp lors de la démonstration de SAS. À partir d’une demande formulée en langage naturel, l’agent de SAS Viya a construit un tableau de bord complet, prêt à être partagé.
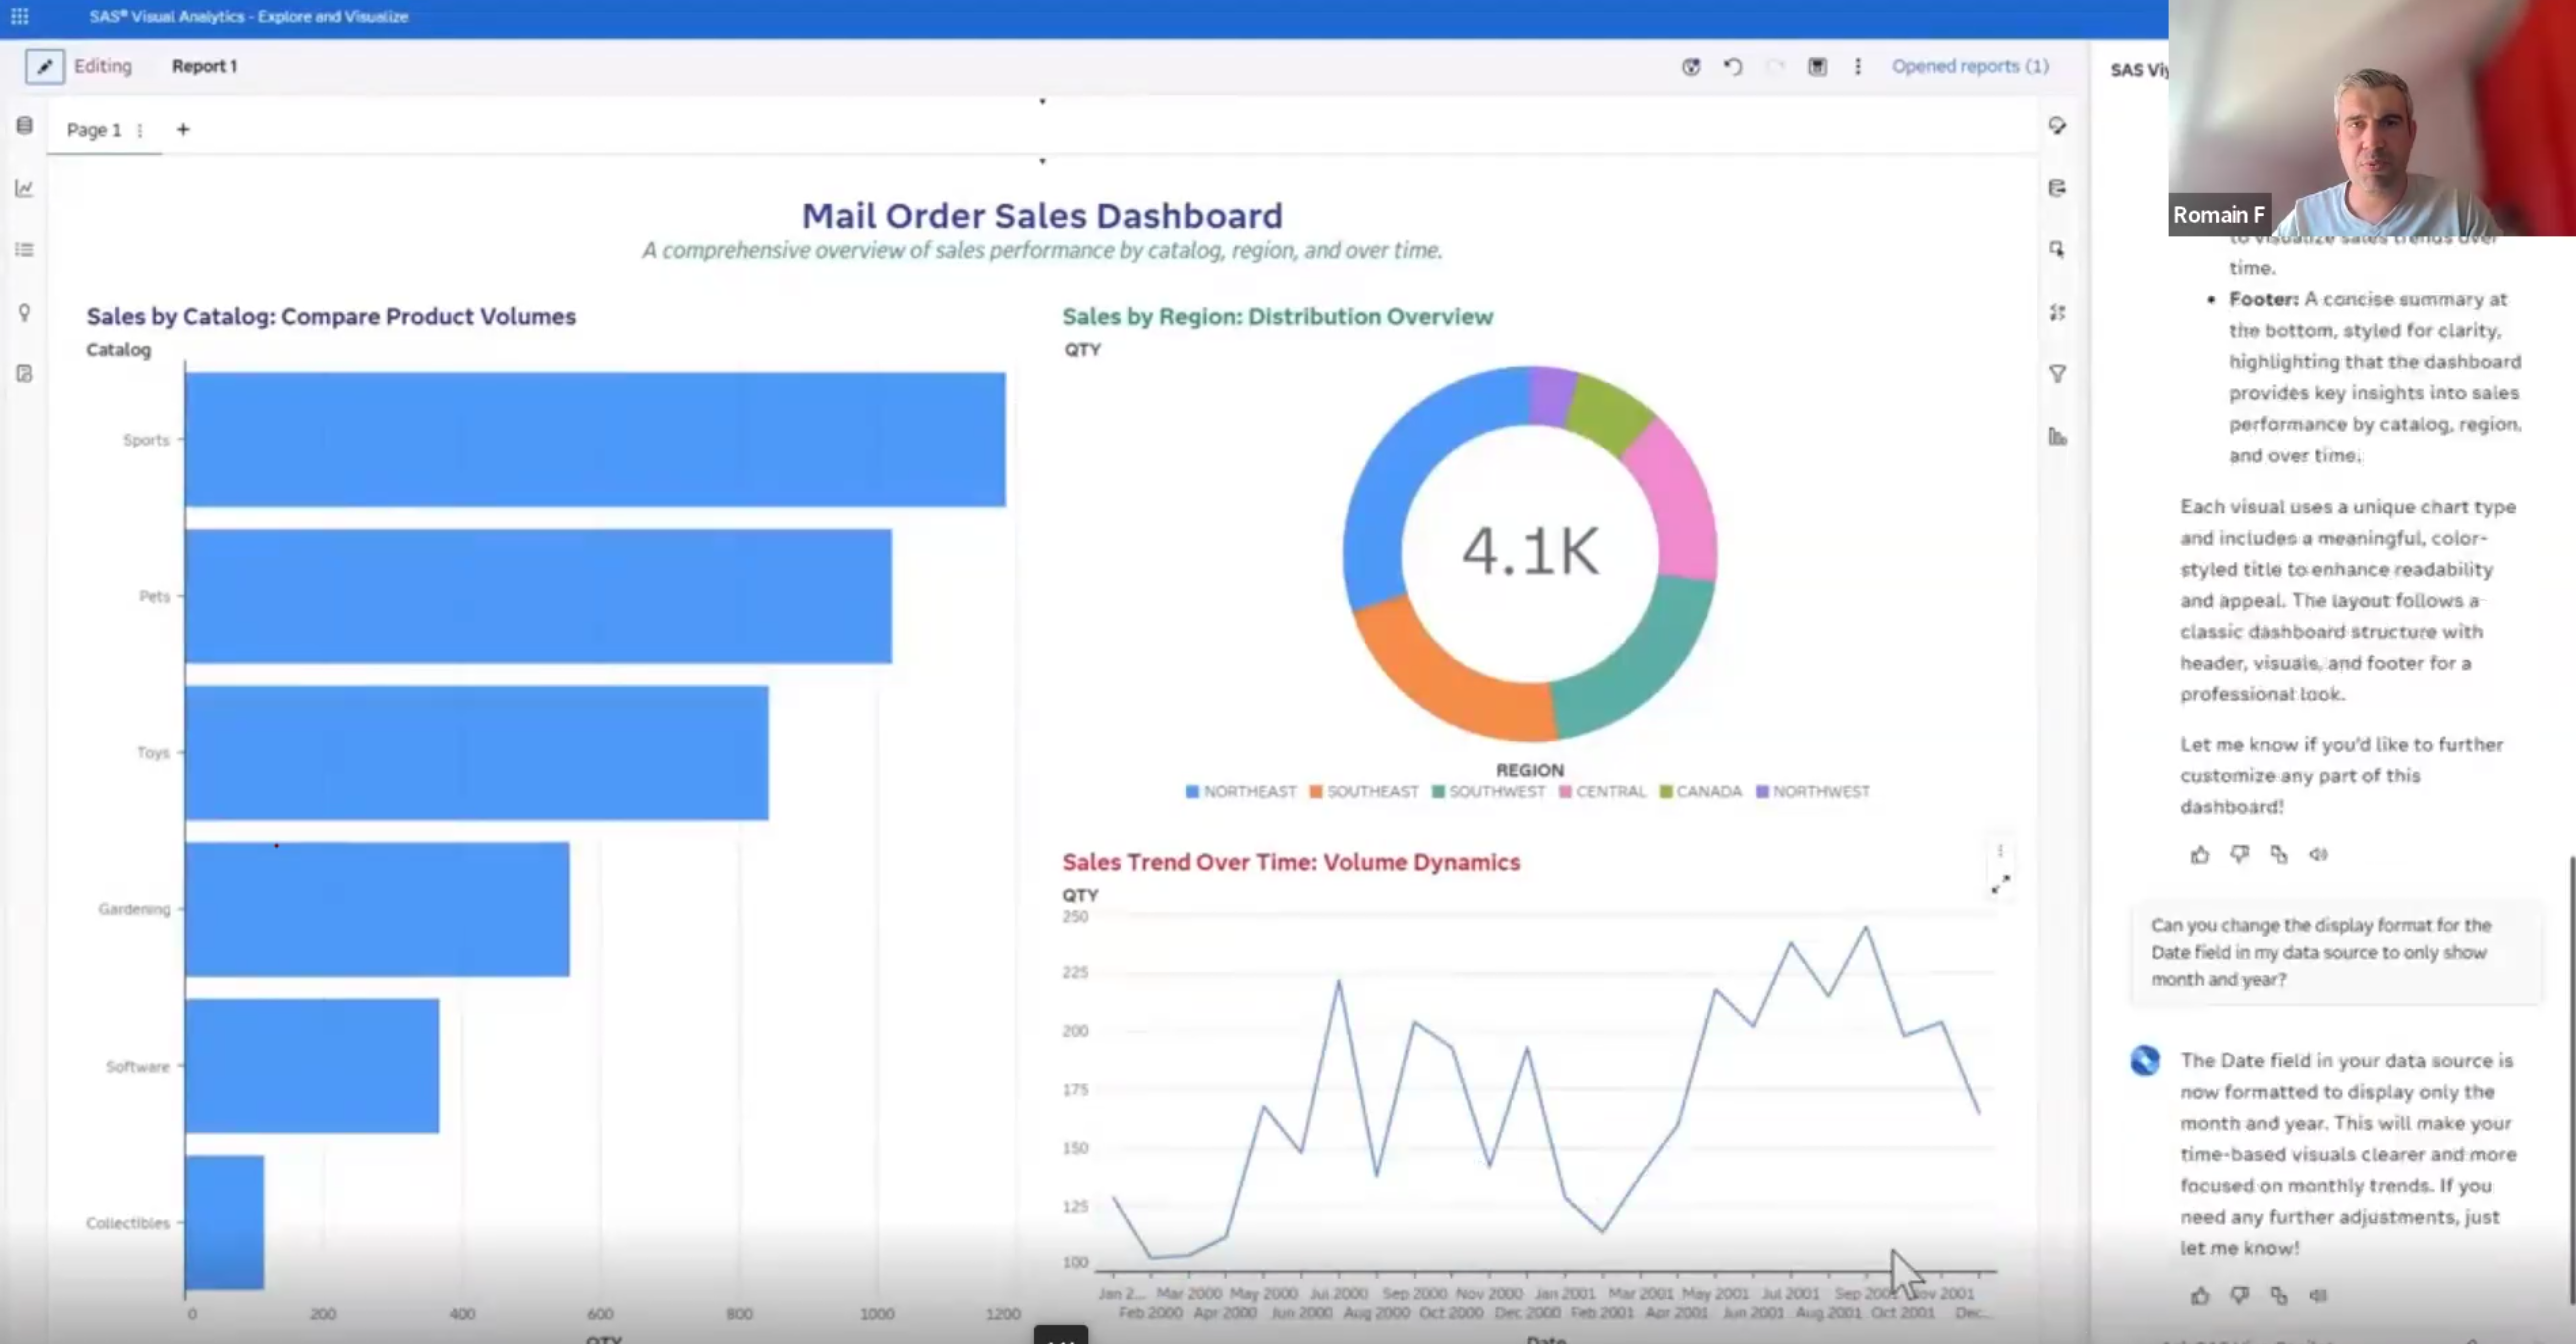
Un tableau de bord complet construit par l’agent à partir d’une simple demande (exemple : SAS Viya).
Qlik Answers génère de son côté des feuilles d’analyse et des graphiques à partir d’une simple consigne.
Deux prérequis conditionnent la valeur de cet usage :
- Une base propre et un modèle de données structuré, décrit dans une couche sémantique, pour que l’IA trouve les bonnes réponses.
- Des utilisateurs capables de poser les bonnes questions. La difficulté n’est plus de produire une réponse, mais de formuler une question qui a du sens.
Plus besoin d’attendre plusieurs jours un tableau ad hoc : le rapport arrive en quelques secondes. Le risque change alors de nature. Il ne tient plus au délai mais à la prolifération : si chacun génère ses propres tableaux, avec ses propres définitions, l’entreprise perd sa version unique des chiffres. D’où l’intérêt de certifier quelques tableaux de référence, puis d’enrichir un tableau de bord commercial existant plutôt que d’en multiplier de nouveaux.
Brancher un agent IA sur une base clients, c’est potentiellement envoyer des noms, des emails et des numéros de téléphone à un modèle de langage hébergé hors de l’entreprise. Souvent hors d’Europe, d’ailleurs. La question n’est pas théorique : elle conditionne l’accord de votre délégué à la protection des données et, souvent, celui de la direction.
Les éditeurs que nous avons analysés y répondent de trois façons :
- Masquer les données avant l’appel au modèle. La politique de protection des données personnelles de Creatio détecte les emails, les numéros de téléphone et de carte bancaire, les noms, les adresses… Elle les masque ou les remplace par un jeton réversible avant que la requête n’atteigne le modèle de langage.
- Les retirer des requêtes. Chez Batch, des modèles dédiés retirent les données personnelles des requêtes avant tout envoi aux modèles de langage tiers.
- Ne jamais les exposer à l’agent. Chez DinMo, l’agent passe par les outils de la CDP au lieu d’interroger directement le data warehouse : le modèle de langage n’accède pas aux données personnelles.
Creatio pousse le paramétrage assez loin. La politique s’applique à toute l’entreprise ou à un agent en particulier, en mode observation (elle signale sans agir) ou actif. On peut lui ajouter des expressions régulières et des dictionnaires propres à l’entreprise :
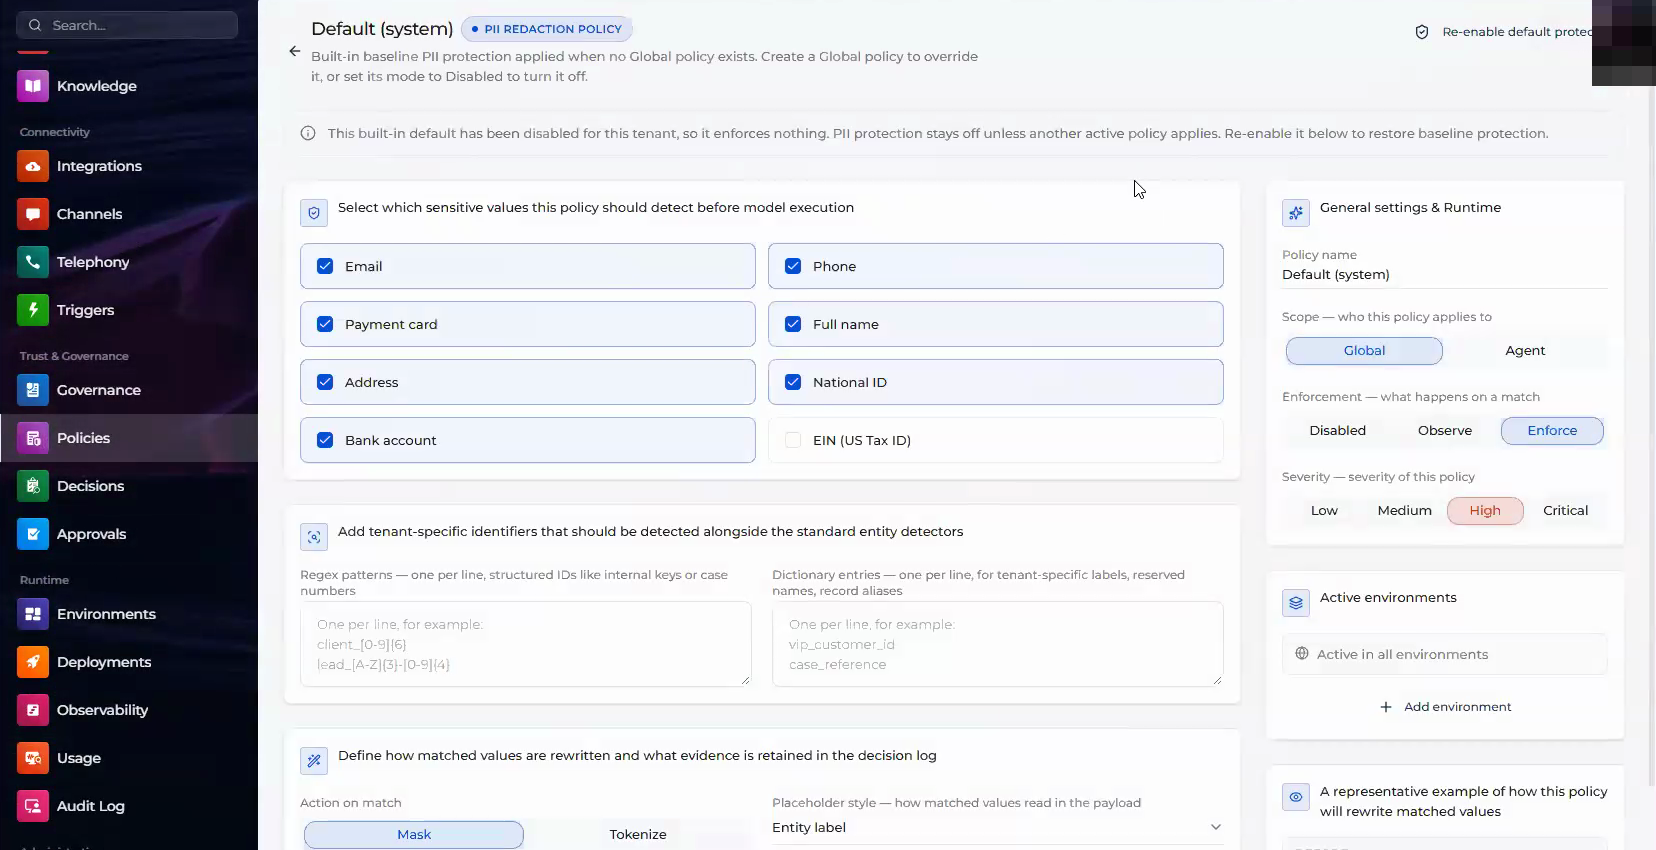
Le paramétrage de la politique de protection des données personnelles (exemple : Creatio).
Chaque intervention est conservée dans un journal des décisions. On y voit, par exemple, un nom et un email remplacés par des étiquettes génériques avant l’appel au modèle :
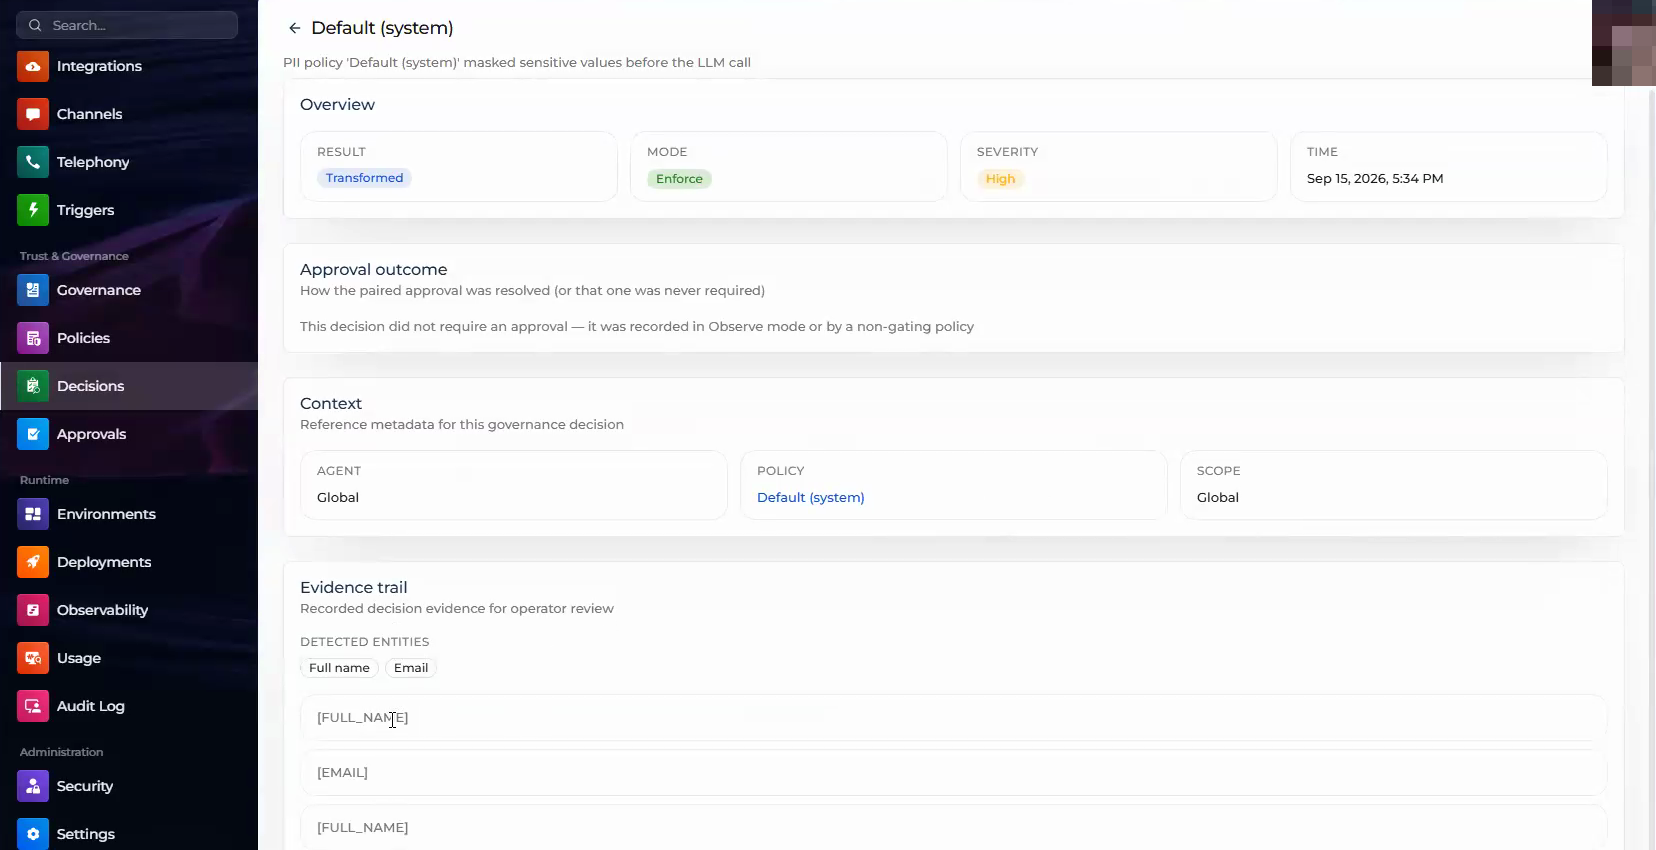
Une décision tracée : nom et email remplacés avant d’atteindre le modèle de langage (exemple : Creatio).
Un point important à signaler : protéger les données d’un agent dont le métier est justement de manipuler des données personnelles demande un réglage fin. Sur l’environnement de démonstration de Creatio, la politique par défaut avait été désactivée… parce qu’elle empêchait la création des contacts ! Prévoyez ce réglage agent par agent, avec votre délégué à la protection des données.
Deux autres questions méritent d’être posées à tout éditeur. Les agents héritent-ils des droits de l’utilisateur connecté, pour ne rien montrer que le CRM ne montre déjà ? Et où sont traitées les données, par quels modèles ? Notre page sur la souveraineté des données donne quelques repères pour cadrer ces sujets.
Au terme de ce tour d’horizon, plusieurs déplacements se dessinent :
- Des équipes data vers les équipes métier. Préparer, segmenter, analyser, construire un tableau de bord : des opérations longtemps réservées aux spécialistes se commandent désormais en langage naturel.
- Des outils isolés vers les plateformes où vivent les données. L’IA de données produits a rejoint le PIM, les modèles prédictifs vivent dans les CDP, les assistants d’analyse s’adossent aux moteurs de BI.
- De la production vers la gouvernance. Quand chacun peut créer un champ calculé, un segment ou un tableau de bord, la question décisive devient celle des définitions partagées : qui décide de ce qu’est un client actif, un chiffre d’affaires, un churner ?
- Du modèle vers le contexte. Les modèles de langage sont de plus en plus comparables d’une plateforme à l’autre. Ce qui distingue une solution, c’est ce qu’elle sait de vos données.
- De l’accès libre vers la protection. Masquage, droits hérités, traçabilité : la façon dont une plateforme protège les données personnelles devient un critère de choix à part entière.
Le point de départ, lui, ne change pas : un besoin métier clair et des données fiables.
CustUp vous aide à intégrer l'Intelligence Artificielle dans votre gestion et votre analyse des Données Clients
Résolument tournés vers le Conseil Opérationnel, nous accompagnons nos clients dans leurs premiers usages de l’IA appliquée à la gestion et à l’analyse des Données Clients, à partir des données et des outils dont ils disposent déjà. L’objectif : faire monter les équipes en compétences, expérimenter et obtenir rapidement des premiers résultats.
Une intervention type se déroule en quatre étapes :
- Diagnostic et plan d’action. Nous analysons vos objectifs, vos systèmes, vos Données Clients et vos pratiques pour repérer les cas d’usage qui comptent.
- Choix et paramétrage des solutions. Nous privilégions l’IA de vos éditeurs actuels, complétée si besoin par des solutions externes. Nous aidons aussi à structurer le modèle de données et le glossaire métier.
- Formation et accompagnement. Nous formons vos équipes data, IT et marketing pendant le déploiement et aux premiers temps de l’usage.
- Suivi des performances. Nous mesurons l’impact des usages déployés et nous les ajustons.
Issus du Marketing-Ventes, nous faisons le lien entre votre stratégie marketing, sa mise en œuvre via les Données Clients et les outils de l’écosystème CRM.
Vous avez un Projet IA ? Échangeons !
Contactez notre expert

Florent Mariotti
Améliore l’efficacité de vos stratégies d’acquisition, de fidélisation et de relation client
Vous avez des projets ? Parlons-en !
Indiquez-nous vos coordonnées et éventuellement quelques mots sur votre besoin, nous vous contacterons dans les plus brefs délais pour un échange.